面试八股 
约 1178 个字 74 行代码 预计阅读时间 6 分钟
Transformer
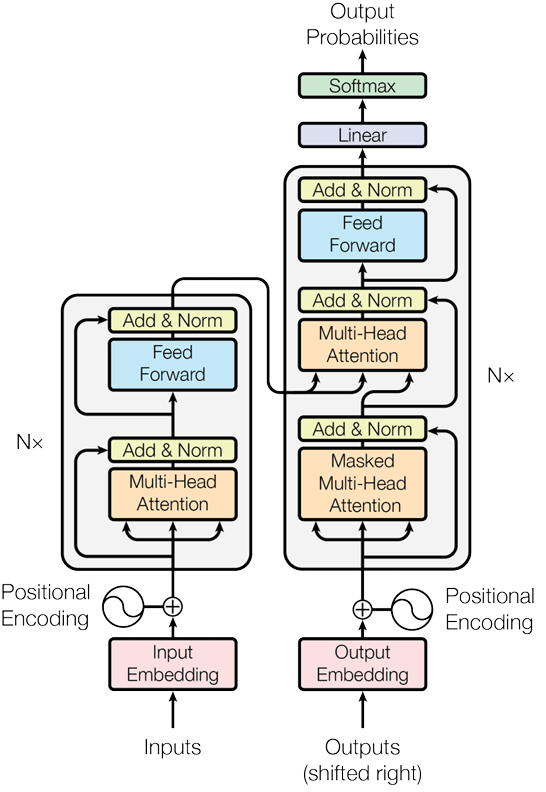
为什么需要 Transformer 
在深度学习中,处理序列数据 ( 如句子、时间序列 ) 是一个核心任务。早期使用 RNN( 循环神经网络 ),但它有两个致命缺点 :
-
无法并行计算 : 必须按顺序一个词一个词处理,训练慢。
-
长距离依赖问题 : 句子太长时,前面的信息容易“遗忘”。
Transformer 彻底抛弃了 RNN, 只用注意力机制 (Attention),解决了上述问题
输入为什么要乘 \(\sqrt{d_{model}}\) 
Transformer 输入是:
$$ X = Embedding + PositionEmbedding $$ 两者直接逐元素相加。如果\(E\)和\(PE\)的数值尺度差太多,相加后一方会主导另一方,而词嵌入矩阵一般用较小方差的分布初始化,因此要乘\(\sqrt{d_{model}}\)
Self-attention
自注意力公式如下 :
import torch
import torch.nn as nn
import math

class SelfAttention(nn.Module):
    def __init__(self, embed_dim, dropout=0.1):
        super().__init__()
        self.embed_dim = embed_dim
        self.W_q = nn.Linear(embed_dim, embed_dim)
        self.W_k = nn.Linear(embed_dim, embed_dim)
        self.W_v = nn.Linear(embed_dim, embed_dim)
        self.W_o = nn.Linear(embed_dim, embed_dim)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x, mask=None):
        Q = self.W_q(x)
        K = self.W_k(x)
        V = self.W_v(x)

        d_k = self.embed_dim
        scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(d_k)

        if mask is not None:
            scores = scores.masked_fill(mask == 0, -1e9)

        attn_weight = torch.softmax(scores, dim=-1)
        attn_weight = self.dropout(attn_weight)

        output = torch.matmul(attn_weight, V)
        output = self.W_o(output)
        return output
Multi Head Self-attention
import torch
import torch.nn as nn
import math

class MultiHeadAttention(nn.Module):
    def __init__(self, d_model, num_heads, dropout=0.1):
        super().__init__()
        assert d_model % num_heads == 0
        self.d_model = d_model
        self.num_heads = num_heads
        self.head_dim = d_model // num_heads

        self.W_q = nn.Linear(d_model, d_model)
        self.W_k = nn.Linear(d_model, d_model)
        self.W_v = nn.Linear(d_model, d_model)
        self.W_o = nn.Linear(d_model, d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x, mask=None):
        B, L, D = x.shape

        Q = self.W_q(x)
        K = self.W_k(x)
        V = self.W_v(x)

        # 拆多头: (B, L, D) -> (B, h, L, head_dim)
        Q = Q.view(B, L, self.num_heads, self.head_dim).transpose(1, 2)
        K = K.view(B, L, self.num_heads, self.head_dim).transpose(1, 2)
        V = V.view(B, L, self.num_heads, self.head_dim).transpose(1, 2)

        # 缩放点积注意力
        scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.head_dim)

        if mask is not None:
            scores = scores.masked_fill(mask == 0, -1e9)

        attn = torch.softmax(scores, dim=-1)
        attn = self.dropout(attn)

        out = torch.matmul(attn, V)                       # (B, h, L, head_dim)
        out = out.transpose(1, 2).contiguous().view(B, L, D)  # 合并多头
        out = self.W_o(out)
        return out
FFN 中间维度为什么要放大?
- 增加非线性表达能力:注意力层主要负责混合不同 token 的信息,而 FFN 负责对每个 token 独立做非线性变换。
- 提供足够的参数容量:Transformer 的参数大部分其实在 FFN 里
为什么要除以根号 d_k 
从上面公式看,\(E(QK^T)=0,Var(QK^T)=d_k\) . 因此存在问题:
- 点积方差不稳定,和模型隐藏层维度 \(d_k\) 有关
- 反传梯度不稳定,过 softmax 后梯度消失
残差连接解决了什么问题 
- 缓解梯度消失,让梯度可以直接通过恒等路径回传;
- 让深层网络更容易训练;
- 保留原始信息,子层只需学习“残差”。
位置编码有哪些,为什么需要位置编码 
自注意力机制是排列不变的,无法感知词序,必须显示注入位置信息才能建模序列顺序。
正弦余弦位置编码 
可学习位置编码 
设最大序列长度为 \(L_{max}\),模型维度为 \(d_{model}\)。定义一个可学习矩阵:
对于位置 \(pos\),取出对应行:
然后加到 token 嵌入上:
优点
- 可外推到训练未见的更长序列
- 无额外参数,泛化性好
相对位置编码 
常见做法是在注意力分数上加一个偏置:
其中 \(B\) 根据 query 和 key 的相对距离 \(i - j\) 生成 , 也是一个可学习参数矩阵。
RoPE: 旋转位置编码 
它不把位置向量加到输入上,而是对 query 和 key 做旋转。
设向量维度为 \(d\),把它分成 \(d/2\) 对。对第 \(m\) 对 \((x_{2m}, x_{2m+1})\),定义频率:
在位置 \(pos\) 处的旋转矩阵为:
对 query 和 key 分别旋转:
然后计算注意力分数:
由于旋转矩阵的性质,点积结果只依赖于相对位置 \(pos_q - pos_k\)。
ALiBi
其中 \(i \geq j\),因为通常用于因果注意力 , 一般 \(m_h = \frac{1}{2^h}\)。
BM 和 LyN 的区别 
为什么要引入 Normalization
1. 梯度稳定:可能会出现梯度不稳定的现象,最后导致梯度爆炸; 2.激活函数存在饱和区间:输入过大过小可能导致进入饱和区间,使得梯度为0。
BatchNorm
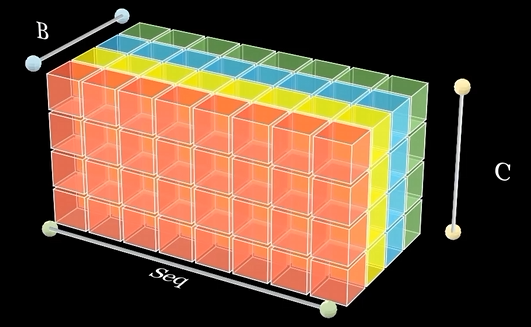
BatchNorm 是在 batch 维度上做归一化,也就是“跨样本”统计。对不同的 C 维度 ( 特征维度 ) 进行归一化,有 C 个均值和方差,缺点有:
- 小 batch 下不稳定
- 推理和训练不一致
LayerNorm
LayerNorm 是在 特征维度上做归一化,不跨样本。对不同的 B 维度 (Batch) 进行归一化,有 B 个均值和方差
- 稳定了每层的输入分布
- 加速训练收敛
Post-LN 和 Pre-LN 
| Post-LN | Pre-LN | |
|---|---|---|
| LayerNorm 位置 | 残差相加之后 | 子层输入之前 |
| 公式 | \(x_{l+1} = \text{LN}(x_l + F(x_l))\) | \(x_{l+1} = x_l + F(\text{LN}(x_l))\) |
| 残差路径 | 梯度要经过 LN | 梯度直接恒等回传 |
| 训练稳定性 | 较差,需 warmup | 较好,易训练 |
| 收敛速度 | 较慢 | 较快 |
| 代表模型 | 原始 Transformer、BERT | GPT-⅔、LLaMA |
| 最终性能 | 调参后可能略好 | 稳定且效果好 |