DreamZero
约 465 个字 预计阅读时间 2 分钟
利用视频生成模型本身已经学习到的 spatiotemporal priors。作者认为视频预测天然包含了大量“物理世界如何变化”的信息
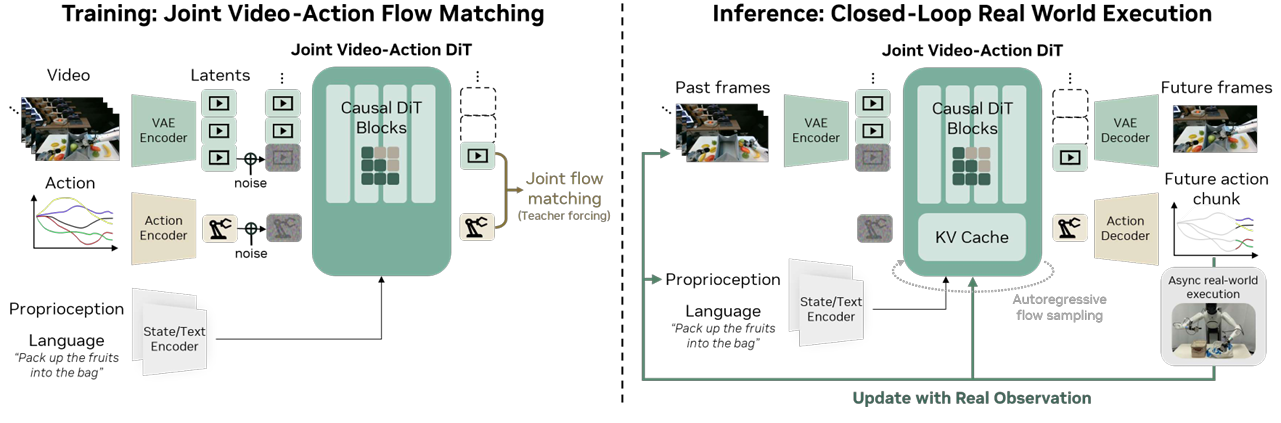
联合预测 
许多常见的 WAM 都是先预测下一帧的世界,然后根据下一帧预测的信息,再通过逆动力学 (IDM) 或者辅助动作块来预测动作,但是这种效率慢且 video-action 之间变化可能不一致
论文把 DreamZero 的联合预测写成:
\[ \pi_\theta ( o_{l:l+H}, a_{l:l+H} \mid o_{0:l},c,q_l ) \]
然后分解为:
\[ \underbrace{ \pi_\theta ( o_{l:l+H} \mid o_{0:l},c,q_l ) }_{\text{Video Prediction}} \cdot \underbrace{ \pi_\theta ( a_{l:l+H} \mid o_{0:l+H},q_l ) }_{\text{Inverse Dynamics Model}} \]
这个公式非常重要。它实际上告诉我们 DreamZero 在概念上可以理解成:
当前世界 ↓ Video Prediction ↓ 预测未来视觉轨迹 ↓ Inverse Dynamics ↓ 机器人动作
也就是:
\[ \boxed{ \text{What should happen?} \rightarrow \text{How should I move?} } \]
不过有一点特别重要:
论文只是“概率分解”成这两个部分,并不是实际训练两个独立网络。
作者紧接着明确说,他们没有使用:
Video Model
     ↓
IDM
两个独立模型。
而是:
          Shared DreamZero DiT
                 ↓
        Joint Video-Action
             Prediction
单一模型端到端联合学习 video 和 action,希望通过共享表示让两种模态高度对齐。
DreamZero-Flash
普通 DreamZero 同时 denoise:
\[ video + action \]
如果 diffusion step 太少,video 还是很 noisy,此时 action quality 会下降。
作者于是提出:
\[ t_k^{video} \neq t_k^{action} \]
标准版本:
\[ t^{video}=t^{action}\sim U(0,1) \]
Flash 中:
\[ t^{video}=1-\eta, \qquad \eta\sim Beta(7,1) \]
而:
\[ t^{action}\sim U(0,1) \]
因此训练时故意让模型学习:
video 还很 noisy 的情况下,也要把 action 预测得很干净。
这样 inference 可以从:
\[ 4\text{ denoising steps} \]
降到:
\[ 1 \]
普通 DreamZero 1-step:
\[ 52\% \]
而 DreamZero-Flash 1-step:
\[ 74\% \]
4-step baseline:
\[ 83\% \]
同时 inference 大约:
\[ 350ms\rightarrow150ms \]